Threads, Ractors e Fibers no Ruby 4: o que aprendi medindo antes de construir um servidor de email
Estou começando um projeto pessoal: o Mailractor, um servidor de email escrito em Ruby. Antes de escrever a primeira linha de SMTP, quis responder uma pergunta que define toda a arquitetura: qual modelo de concorrência do Ruby moderno aguenta esse tipo de carga?
O Ruby 4 tem três respostas na mesa:
- Threads: o modelo clássico, limitado pelo GVL (só uma thread executa Ruby por vez).
- Ractors: paralelismo de verdade, com isolamento de memória, numa API que mudou bastante no Ruby 4.0.
- Fibers com um escalonador (
Fiber::Scheduler, aqui via gemasync): concorrência cooperativa, com um laço de eventos por thread.
Em vez de escolher por intuição, montei uma POC de benchmarks. Este post resume o que medi, o que me surpreendeu e os bugs do Ruby que apareceram no caminho (um deles virou o Bug #22439). Todo o código, os resultados brutos e o relatório completo estão em github.com/amalrik/ruby-ractors-study.
Como medi
Algumas regras que segui para não me enganar com os números:
- Mesmo trabalho e mesma validação em todos os modos. Contar primos tem resultado conferido contra um crivo de Eratóstenes. Cada sessão de rede valida resposta por resposta.
- Cada caso roda num processo Ruby novo, com uma rodada de aquecimento e 3 a 5 repetições. Reporto mediana e mínimo/máximo, nunca só o melhor resultado.
- Inicialização, processamento e encerramento medidos separadamente, junto com CPU, memória (RSS de pico) e latência p50/p95/p99.
- Ambiente registrado em cada execução: CPU, versão do Ruby e, na nuvem, o steal (CPU que o hipervisor dá a outras máquinas virtuais).
As máquinas: um laptop com Ryzen 7 5700U (8 núcleos/16 threads) e, depois, uma VM na Hetzner (CPX42, 8 vCPU AMD EPYC). Rodei tudo em Ruby 4.0.6 e repeti em 4.0.7 e 4.1.0-preview1. A versão fez toda a diferença.
1. CPU: Ractors entregam, threads não
O primeiro teste é o mais previsível: contar primos em 2 milhões de números, divididos em blocos independentes.
| Modo (Ruby 4.0.6, 512 blocos) | Tempo | Speedup |
|---|---|---|
| sequencial | 3,17 s | 1,0× |
| 8 threads | 3,10 s | 1,02× |
| 8 Ractors | 0,59 s | 5,4× |
| 16 Ractors | 0,59 s | 5,4× |
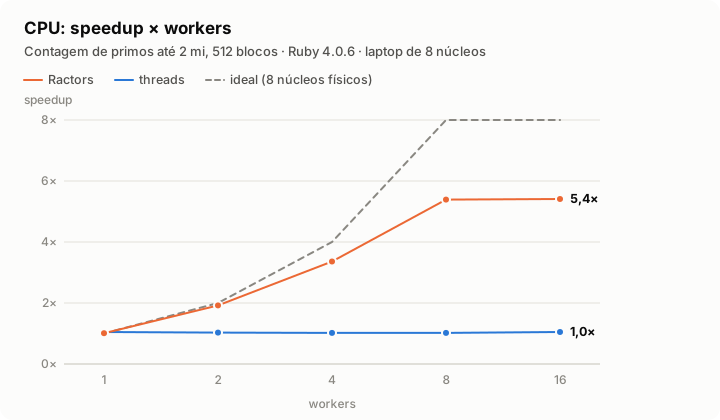
Threads não ajudam nada em Ruby puro: o GVL serializa a execução. Ractors escalam até o número de núcleos físicos. Criar um Ractor custa ~45 µs, então o custo de inicialização é desprezível.
Dois detalhes interessantes:
- 16 Ractors não são melhores que 8. Na 4.0, o escalonador usa no máximo
RUBY_MAX_CPUthreads nativas (padrão 8). Liberando 16, ficou mais lento (0,70 s): os núcleos lógicos de SMT não rendem nesse tipo de laço. - Granularidade importa. Com tarefas de ~0,4 ms, a troca de mensagens já custa 8% mesmo com um Ractor só. Com tarefas de alguns milissegundos, esse custo some.
2. I/O: a armadilha do “receive antes do I/O”
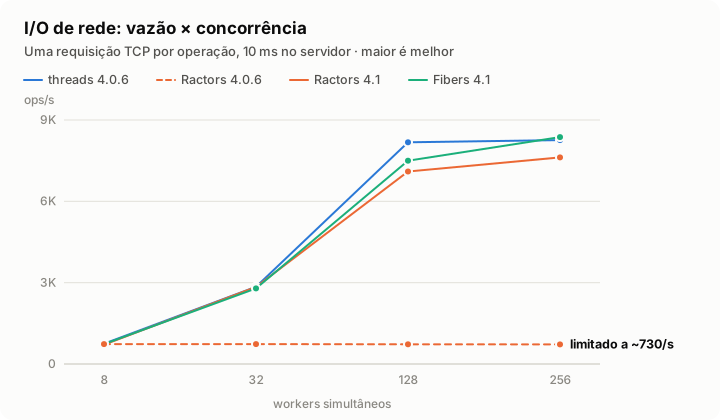
Para I/O, simulei operações que esperam a rede: cada operação abre uma conexão com um servidor local que responde depois de 10 ms.
Threads foram muito bem: com 256 threads, ~8.200 operações/s. Já os Ractors travaram em ~730 operações/s, com 8 ou com 256 workers. O servidor nunca via mais que ~15 conexões simultâneas.
Fui investigar se era erro meu. O pool de Ractors tinha um despachante central, e suspeitei dele, depois do Enumerator#next. Não era nenhum dos dois. A pista veio de contar as threads nativas do processo:
| Ruby 4.0.7, 64 Ractors, 400 operações | Tempo | Threads nativas |
|---|---|---|
| Ractor começa direto no I/O com timeout | 0,12 s | ~67 |
Ractor espera Ractor.receive e depois faz I/O | 0,59 s | 10 |
No escalonador M:N do Ruby 4.0, um Ractor que já ficou bloqueado esperando mensagem (exatamente o que todo worker de pool faz) não ganha thread nativa própria. Daí em diante, cada wait_readable(timeout) ocupa uma das ~8 threads compartilhadas. O resultado é um limite invisível de ~8 operações de I/O simultâneas. Nada avisa: o programa só fica lento.
A boa notícia: na 4.1.0-preview1 isso foi corrigido (0,104 s, com ~18 threads nativas). O reprodutor está em io_bound/bin/repro_ractor_receive_first.rb.
3. Sessões parecidas com SMTP: onde a coisa fica séria
Uma requisição por conexão não representa um servidor de email. Montei então sessões com 7 idas e voltas (banner, EHLO, MAIL, RCPT, DATA com 4 KB, QUIT), com 10 ms de espera antes de cada resposta e timeout em toda leitura, como um servidor SMTP real precisa.
Até ~1.000 sessões simultâneas, threads e Fibers empatam. Acima disso, o gargalo muda de natureza. Com 10 mil sessões no Ruby 4.0.6, as Fibers entregaram 745 sessões/s, e o p50 da sessão foi de 12,9 s. Isso é a lei de Little em ação:
latência média ≈ concorrência ÷ vazão = 10.000 ÷ 745 ≈ 13,4 s
Ou seja, a latência virou fila. Um único processo Ruby satura um núcleo de CPU, e as sessões esperam a vez. Medir CPU junto com latência foi o que mostrou isso; sem o cpu_util, eu teria culpado a rede.
Outros números que pesam para um servidor com milhares de conexões:
- Threads: com 10 mil sessões, 646 MB de memória e ~6 s só para criar as threads.
- Fibers: 357 MB e 0,1 s para criar.
- Na 4.1, as Fibers melhoraram muito com alta concorrência: 10 mil sessões em 10,0 s, contra 40,4 s na 4.0.6.
4. O teste que importa: o servidor
Até aqui eu tinha comparado modelos de cliente. Mas a pergunta do Mailractor é sobre o servidor. Então tornei o servidor plugável e fixei o gerador de carga:
- threads: uma thread por conexão;
- fibers: um processo, uma Fiber por conexão;
- prefork + fibers: 4 processos (fork) aceitando do mesmo socket, cada um com seu laço de eventos;
- Ractors + fibers: 1 processo, 4 Ractors, cada um com seu próprio socket de escuta (
SO_REUSEPORT, o kernel distribui as conexões) e seu próprio reatorasync.
Rodei numa VM descartável da Hetzner (custou centavos), com 4 vCPU para o servidor e 4 para o gerador. O steal ficou em 0% em todas as medições. Resultado com 10 mil sessões simultâneas (Ruby 4.1.0-preview1):
| Servidor | Sessões/s | p99 | CPU (caso) | Memória |
|---|---|---|---|---|
| threads | 1.460 | 7,2 s | 124 s | 100 MB |
| fibers (1 processo) | 3.749 | 2,7 s | 32 s | 92 MB |
| prefork + fibers | 12.430 | 0,44 s | 37 s | 317 MB* |
| Ractors + fibers | 9.702 | 1,0 s | 45 s | 145 MB |
* soma dos 4 processos, que conta mais de uma vez as páginas compartilhadas por copy-on-write.
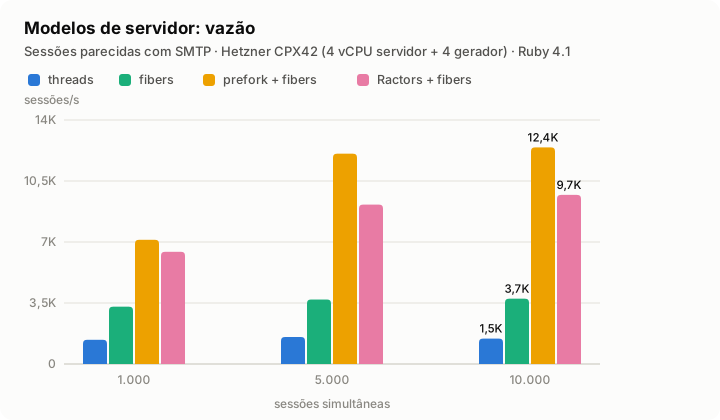
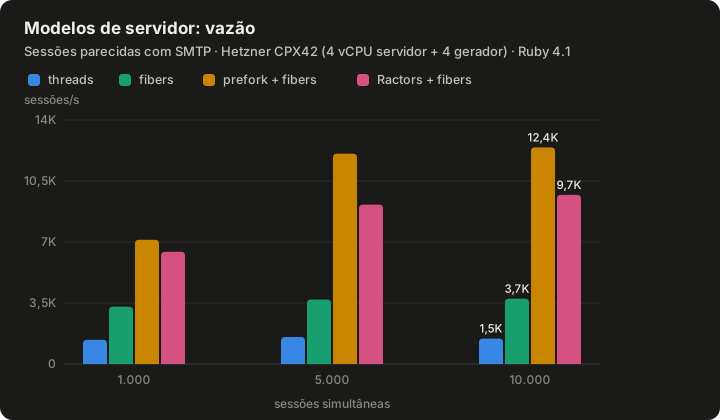
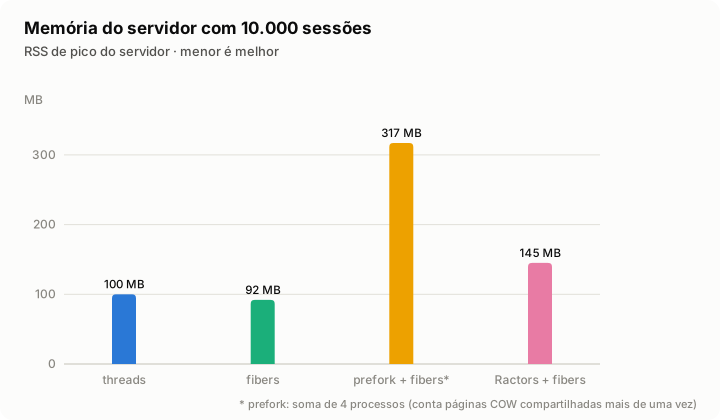
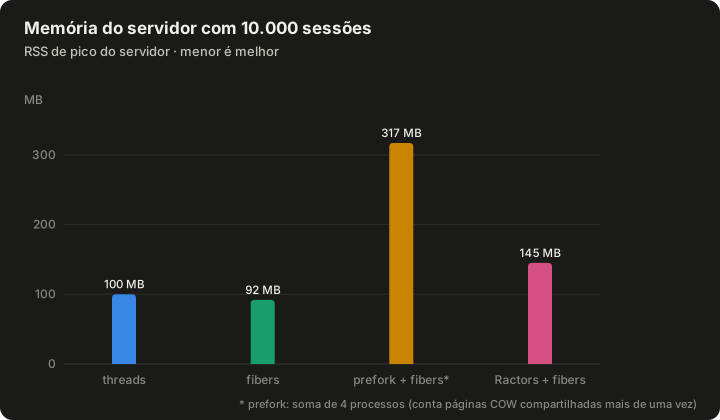
Uma segunda rodada confirmou a ordem. A leitura:
- Thread por conexão não serve para SMTP de entrada. Com 10 mil clientes, o servidor de threads nunca passou de ~1.000 conexões simultâneas e gastou 3–4× mais CPU por sessão.
- Fibers num processo só são ótimas até ~1.000 sessões, depois ficam presas a um núcleo.
- Prefork + Fibers foi o mais rápido, o mais estável e funciona em qualquer versão do Ruby. É o modelo consolidado no ecossistema (Falcon, Puma em modo cluster).
- Ractors + Fibers chegou a ~80% do prefork com metade da memória, num processo só.
5. Ractors + Fibers: paralelismo real dentro de um processo
Esse último ponto foi o que mais me intrigou. No mesmo processo, com Fibers puras, o limite é um núcleo (~3.700 sessões/s). Com 4 Ractors, cada um rodando seu próprio laço de eventos, chegou a ~9.700/s. No cliente, o processo usou 4,6 núcleos ao mesmo tempo.
Funciona porque:
- Cada Ractor tem seu próprio lock de execução. O GVL deixou de ser global entre Ractors, e threads de Ractors diferentes rodam em núcleos diferentes.
- O escalonador de Fibers é por thread. Cada Ractor instala o seu: N laços de eventos independentes, um por núcleo, como num servidor com um laço por núcleo, mas sem fork.
- Nada de socket compartilhado. Cada Ractor abre o próprio listener com
SO_REUSEPORT, o que respeita o isolamento.
Por que o prefork ainda ganha? Minha hipótese, ainda não medida: os Ractors dividem o mesmo heap e o mesmo coletor de lixo. GC e alguns caches internos exigem sincronização entre eles. Processos separados não coordenam nada. Isso combina com o custo de CPU ~20% maior por sessão. Se o GC e os caches ficarem mais independentes entre Ractors em versões futuras, essa diferença tende a cair.
6. Os bugs que encontrei pelo caminho
Um estudo assim vira, sem querer, um teste de estresse da própria linguagem.
Ruby 4.0.6 e 4.0.7: travamentos e corrupção de memória. Clientes de sessão rodando em Ractors travaram em 6 de 20 execuções na 4.0.6 e em 4 de 20 na 4.0.7. Com o gdb, as threads estavam paradas em poll com timeout, mas o timeout nunca disparava (com IO#timeout = 2, o processo ficou parado 60 s). As filas de rede estavam vazias dos dois lados. Uma execução terminou em double free or corruption dentro do sweep do GC. Na 4.1.0-preview1: 0 de 40.
Ruby 4.1: uma regressão. Ao rodar o async em vários Ractors, um processo caiu com segfault. Fui reduzindo até chegar a ~15 linhas, sem nenhuma gem:
1
2
3
4
5
6
7
8
9
10
11
12
13
rs = Array.new(2) do |i|
  Ractor.new(i) do |id|
    500.times do |k|
      begin
        raise ArgumentError, "falha #{id}-#{k}"
      rescue => e
        e.detailed_message(highlight: false)
      end
    end
    :ok
  end
end
p rs.map(&:value) # 4.0.x: [:ok, :ok] — 4.1: [BUG] Segmentation fault
Na 4.1, o error_highlight (aquele ^^^^ embaixo da linha com erro) passou a usar um método novo, Thread::Backtrace::Location#syntax_tree. Chamado a partir de dois Ractors ao mesmo tempo, ele derruba a VM. Com um Ractor só, não cai, mas o trecho destacado some. Relatei como Bug #22439, com reprodutores e a tabela por versão. É relevante porque qualquer biblioteca que registre exceções em log dentro de Ractors pode derrubar o processo na 4.1.
7. Erros de método que cometi (e corrigi)
Registro isto porque benchmark mente fácil:
- Medições contaminadas. Uma vez, outro benchmark rodou em paralelo com o meu e disputou CPU. Tive que descartar e refazer parte da matriz. Lição: confirme que a máquina está ociosa antes de medir.
- Culpei a rede doméstica cedo demais. Do Brasil até a VM na Finlândia, as sessões tinham timeouts de conexão. Primeiro achei que era o gerador. Depois testei abrir 400 conexões de uma vez: zero falhas. O problema só aparecia com taxas sustentadas de conexões novas, e os contadores do kernel do servidor mostraram zero descartes. Os SYN se perdiam no caminho (roteador ou operadora). Ou seja: o teste a partir de casa media a minha rede, não o servidor.
- Uma hipótese bonita que não se confirmou. Suspeitei que a ordem de fechamento das conexões (TIME_WAIT no servidor + NAT reaproveitando portas) causasse as perdas. Testei as duas ordens: o sintoma era o mesmo. Hipótese descartada.
Conclusões para o Mailractor
- Modelo padrão para receber email: processos (prefork) + Fibers. Mais vazão, menor latência de cauda, funciona em qualquer Ruby.
- Ractors + Fibers é uma alternativa real no Ruby 4.1, quando memória e estado compartilhado num processo só pesam mais que ~20% de vazão. É também o caminho que mais gera feedback útil para a linguagem.
- Ractors para CPU puro (parse de MIME, assinaturas, filtros) já funcionam bem, inclusive na 4.0.
- Ractors com sockets na 4.0.x: evitar. Limite de concorrência, travamentos e corrupção de memória.
- Thread por conexão: não.
O que ainda quero medir: gerador e servidor em máquinas separadas, TLS (STARTTLS muda o custo de CPU por sessão), mensagens maiores e o pipeline completo (recepção → spool durável → workers). Fica para os próximos posts.
Se você trabalha com Ractors ou com async, o repositório está aberto: github.com/amalrik/ruby-ractors-study. Críticas à metodologia são muito bem-vindas.